
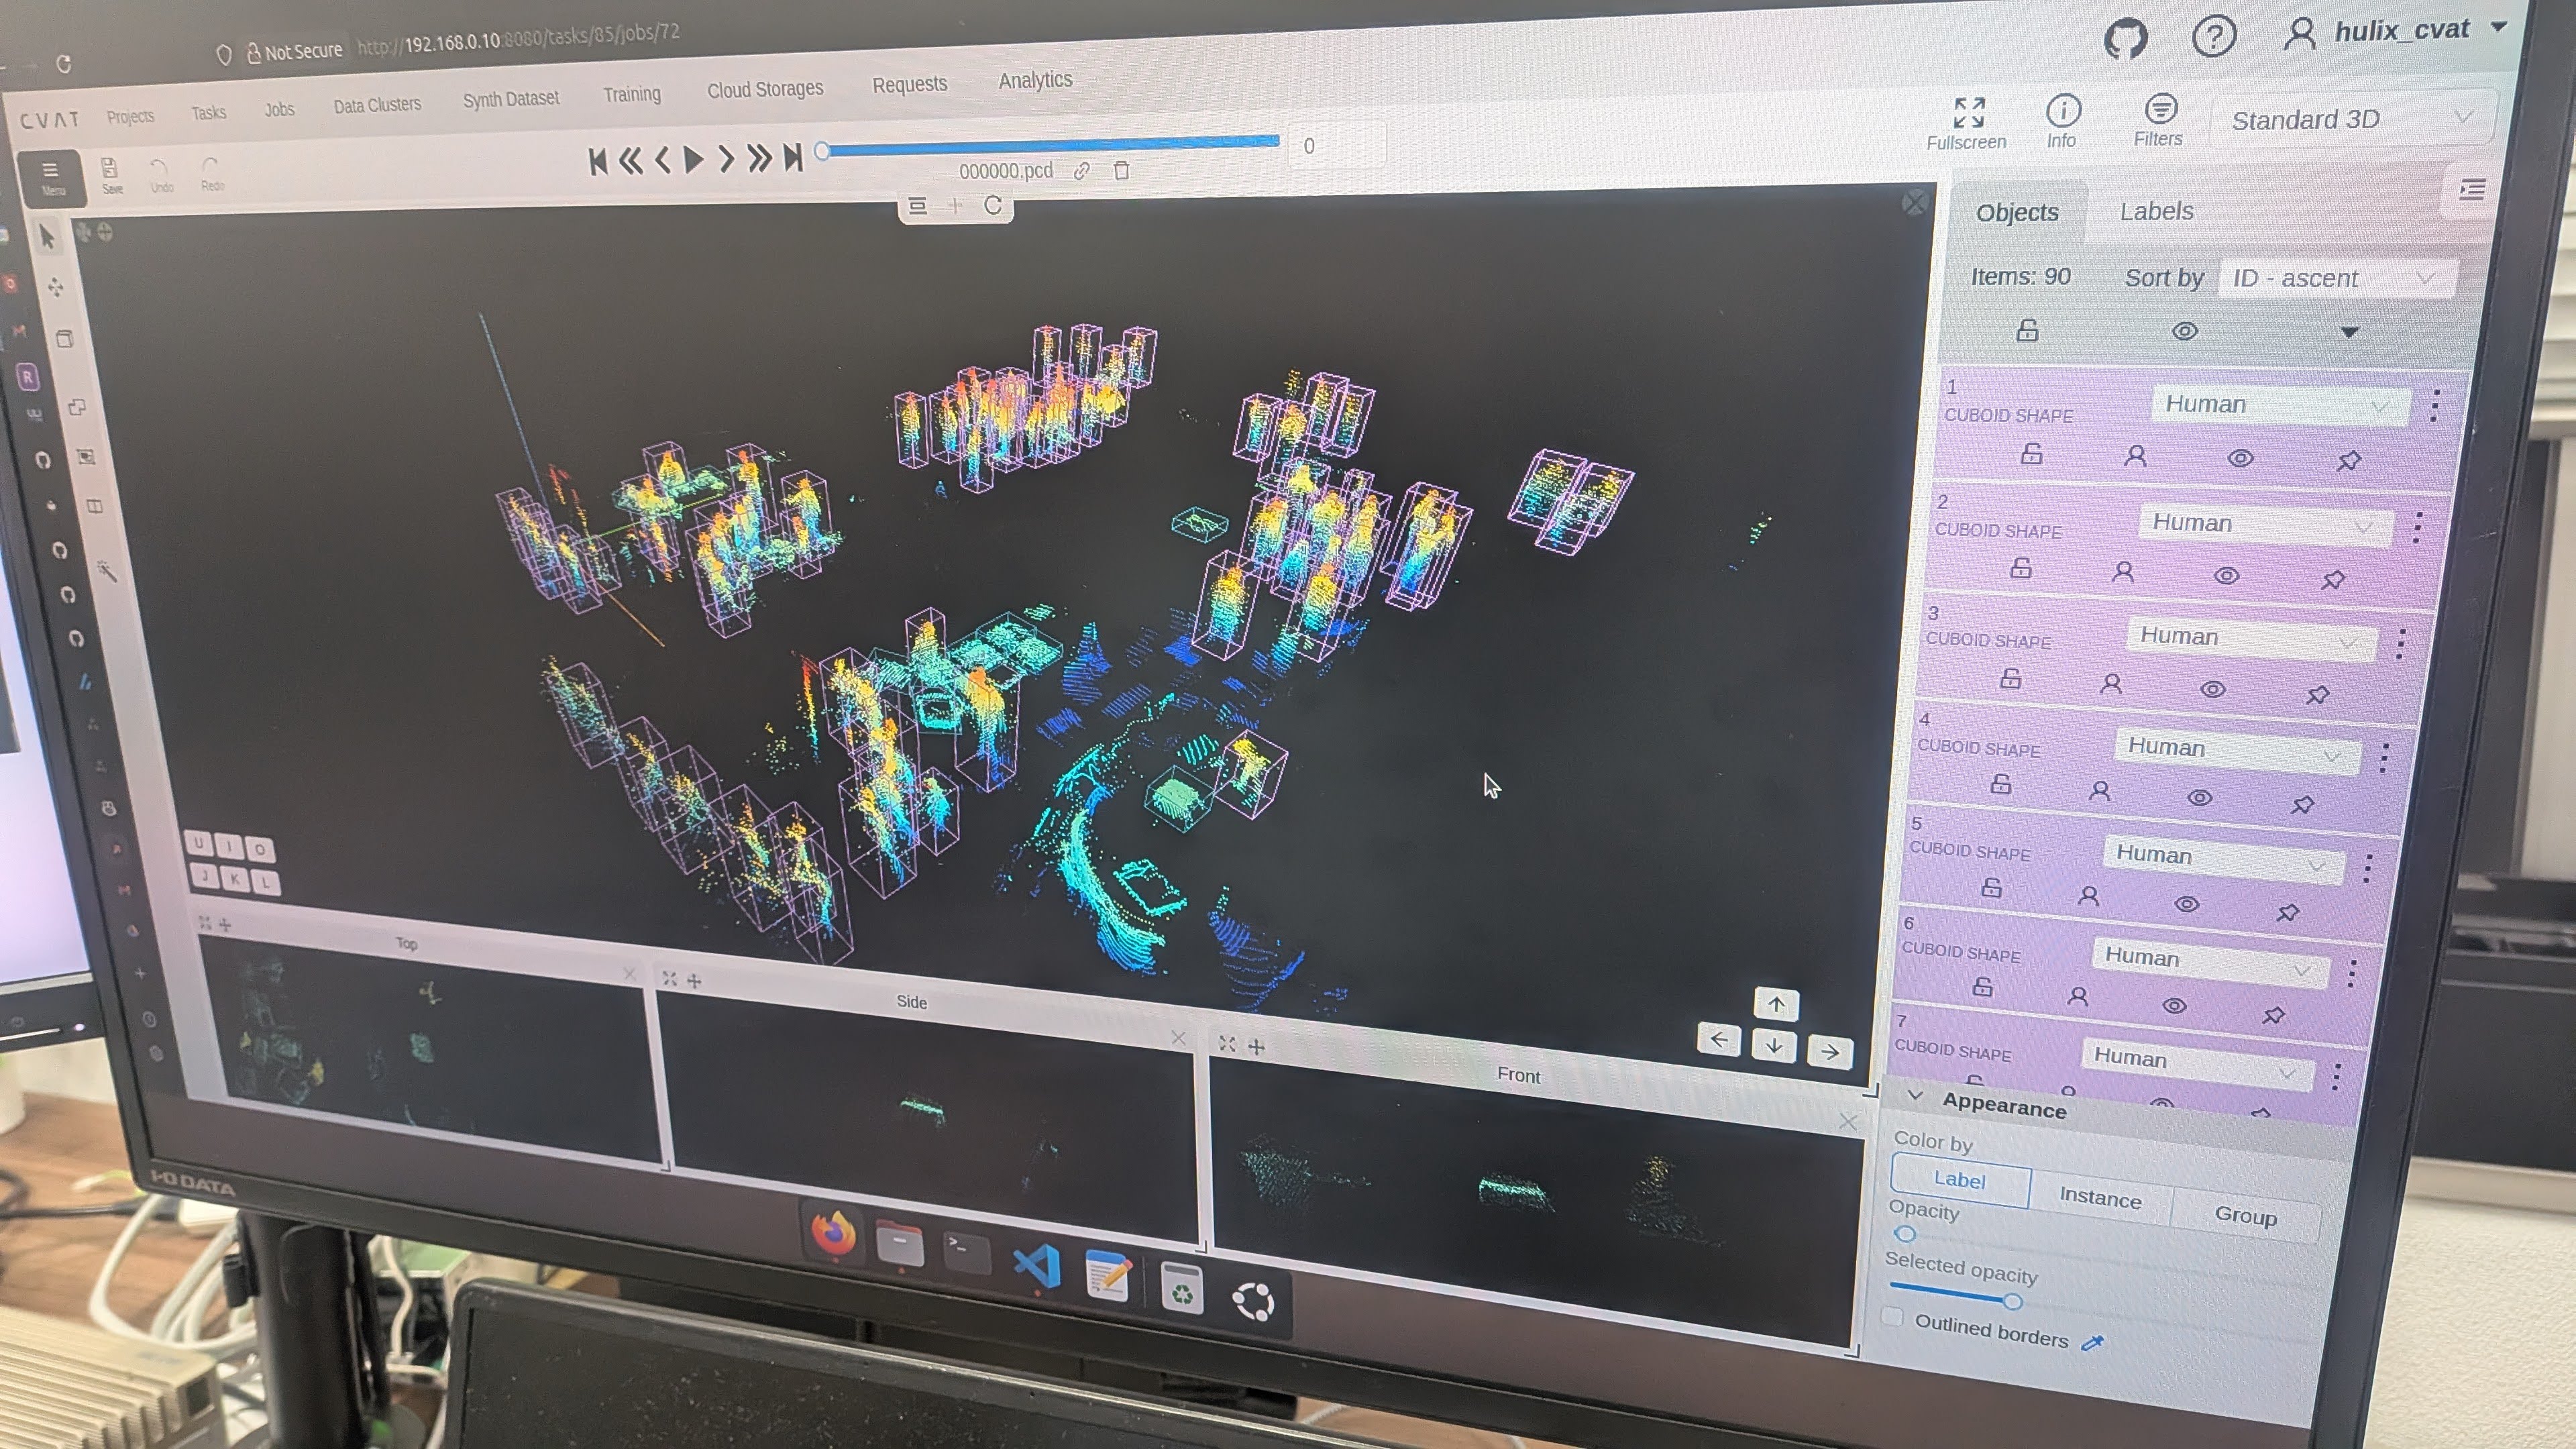
画面に人物の枠が出る。ここまで動くと、追跡もできたように見えます。でも、滞在時間や行列を分析するには、その先が必要です。
「この瞬間、ここに人がいる」が検出。「さっきの人が、今ここにいる」が追跡です。位置だけでなく、時間をまたいで同じ対象をつなぐ必要があります。
人同士が重なる。柱の裏に入る。別のセンサーの範囲へ移る。現場では、ごく普通に起こります。
見えなくなった瞬間に記録を終えると、一人の移動が細切れになります。逆に、長く残せばよいわけでもありません。近くに現れた別人を、同じ人としてつないでしまうことがあります。
HULIXの過去のカメラ評価でも、対象が重なった後に追う相手が入れ替わるケースを、映像で確認しました。検出枠の揺れ、撮影方向、計算機側の処理条件も切り分けています。見失った後に待つ時間だけでは、解決しませんでした。
実装では、観測できている状態、見失って位置を予測している状態、再び対応が取れた状態を区別します。予測で補った位置を、実際に見えていた位置と同じ扱いにすると、後の分析で原因が分からなくなります。
この対応付けをAssociationと呼びます。前の位置から近いものを選ぶだけでは、すれ違う二人を取り違えることがあります。一方、見えなくなった間も強く同一人物だと仮定すると、誤った結合を長く引きずります。
そこで、見えていない状態を、終了した状態とは分けて持ちます。再び対応が取れたときには、どの観測を使って戻したのかを残す。終了するときも、範囲の外へ出たのか、一定時間観測できなかったのかを区別します。後で滞在時間を集計する処理にとって、この終了理由は重要です。
この考え方は、本人の氏名を識別することとは別です。観測している範囲と時間の中で、移動の記録をつなぐためのIDを扱っています。
一枚の画像で人を見つけられても、途中でIDが変われば、長い滞在が短い滞在に分かれます。二人を一人につなげば、実在しない長い待ち時間が生まれることもあります。
つまり、検出の精度と、業務で使う数字の品質は同じではありません。 追跡を評価するときは、最終的に作りたい待ち時間や滞在時間まで見ます。
低い信頼度の検出も対応付けに使うByteTrackは、追跡実装の参考になります。ただし、特定の手法を入れれば現場の評価が不要になるわけではありません。ByteTrack原論文
アノテーションでも、枠を描けば完了ではありません。人の一部しか見えていないときに、何を一つの人物として扱うか。重なった二人をどう区別するか。元の点群で確認できないものに、無理に正解を付けないことも必要です。
検出が抜けたのか、検出はあるのに別の人へつないだのかを分けて調べます。どちらも画面では「追跡が切れた」と見えますが、前者は入力や検出、後者は対応付けを見直す話になります。同じ見た目の失敗でも、直す場所が違うのです。精度の数字を一つ出す前に、この区別ができる記録を用意します。
人がいつも柱に隠れる場所で、追跡の設定だけを調整し続けても限界があります。高さ、向き、距離、遮蔽物、センサー同士の重複範囲を先に見ます。HULIXが設置シミュレータを開発しているのも、現地での手戻りを減らすためです。
複数センサーでは、座標と時刻を揃えます。同じ床面上に見えても、座標がずれていれば別人に見える。時刻がずれていれば、移動している人の位置が食い違う。センサーを増やすほど、この確認が必要になります。
一つの世界座標に統合した結果だけでなく、どのセンサーの、どの観測からつないだかも残す。後から調べるときに、この対応関係が効きます。
重複する範囲を両方のセンサーで見られても、まだ同じ人とつながるとは限りません。一方からは正面、もう一方からは横向きに見える。片方のデータが遅れて届く。近くに別の人がいる。座標、時刻、観測の状態がそろって、初めて対応付けを評価できます。
HULIXの評価設計では、個別センサーのIDと、統合後のIDの関係も記録します。統合後の軌跡だけが滑らかでも、元の対応が何度も切り替わっているかもしれません。表示用のデータと、原因を調べるデータを同じものだと思わない方が、後の実装が楽になります。
現場では、使える回線が数Mbps程度という条件もあります。点群を常時クラウドへ送り、クラウド側だけで全部処理する構成を、どの現場にも持ち込めるわけではありません。
現地で検出と追跡を行い、位置や軌跡、必要な出来事に情報を絞って送る。ただし、通信を減らすことと、調査する材料を消すことは別です。異常が起きた前後の元データをどこに、どれだけ残すかまで考えます。
通信が戻ったときの扱いも決めます。過去の記録をまとめて送るなら、現在の通知と区別する。再送した記録を二重に集計しない。センサーが再起動して番号が振り直されたときに、以前の対象と混ぜない。これらはモデルの精度を上げる話ではありませんが、数週間運用した記録を使うためには欠かせません。
さらに、処理を速くしたいときも、先に遅れている場所を見ます。センサーから届くまでなのか、検出と追跡なのか、クラウドへ送るところなのか。画面の更新間隔だけを短くしても、古いデータを速く表示するだけになることがあります。
計算機を増やす場合には、観測時刻と処理の終了時刻を分けて残します。別々の計算機で動いている処理を一つの軌跡へまとめるなら、どの順番で届いても、同じ時刻の出来事として扱えるかを確かめる。目の前のデモが滑らかに動くことと、後から正しい記録を取り出せることには、別の確認が要ります。
自分で実装するなら、施設全体を覆う前に、入口から出口までの一つの区間を選びます。
この時点から、処理の遅れ、通信量、CPU・GPU負荷、停止後の復帰も記録します。回線が細ければ、現地で処理して軌跡や出来事を送る構成を考えます。ただし、送信量を減らした結果、失敗を調べる元データまで消してしまわないようにします。
HULIXでは、配置検討、座標統合、履歴・再生、評価の道具を蓄積しています。現場で追跡が切れたとき、毎回ゼロから原因を探さずに済むようにするためです。モデルが動いた後の、この調査と確認まで含めて実装を考える必要があります。
同じカテゴリーの他の記事も読む


Copyright ©
HULIX Technologies, Inc.